Faits vérifiés
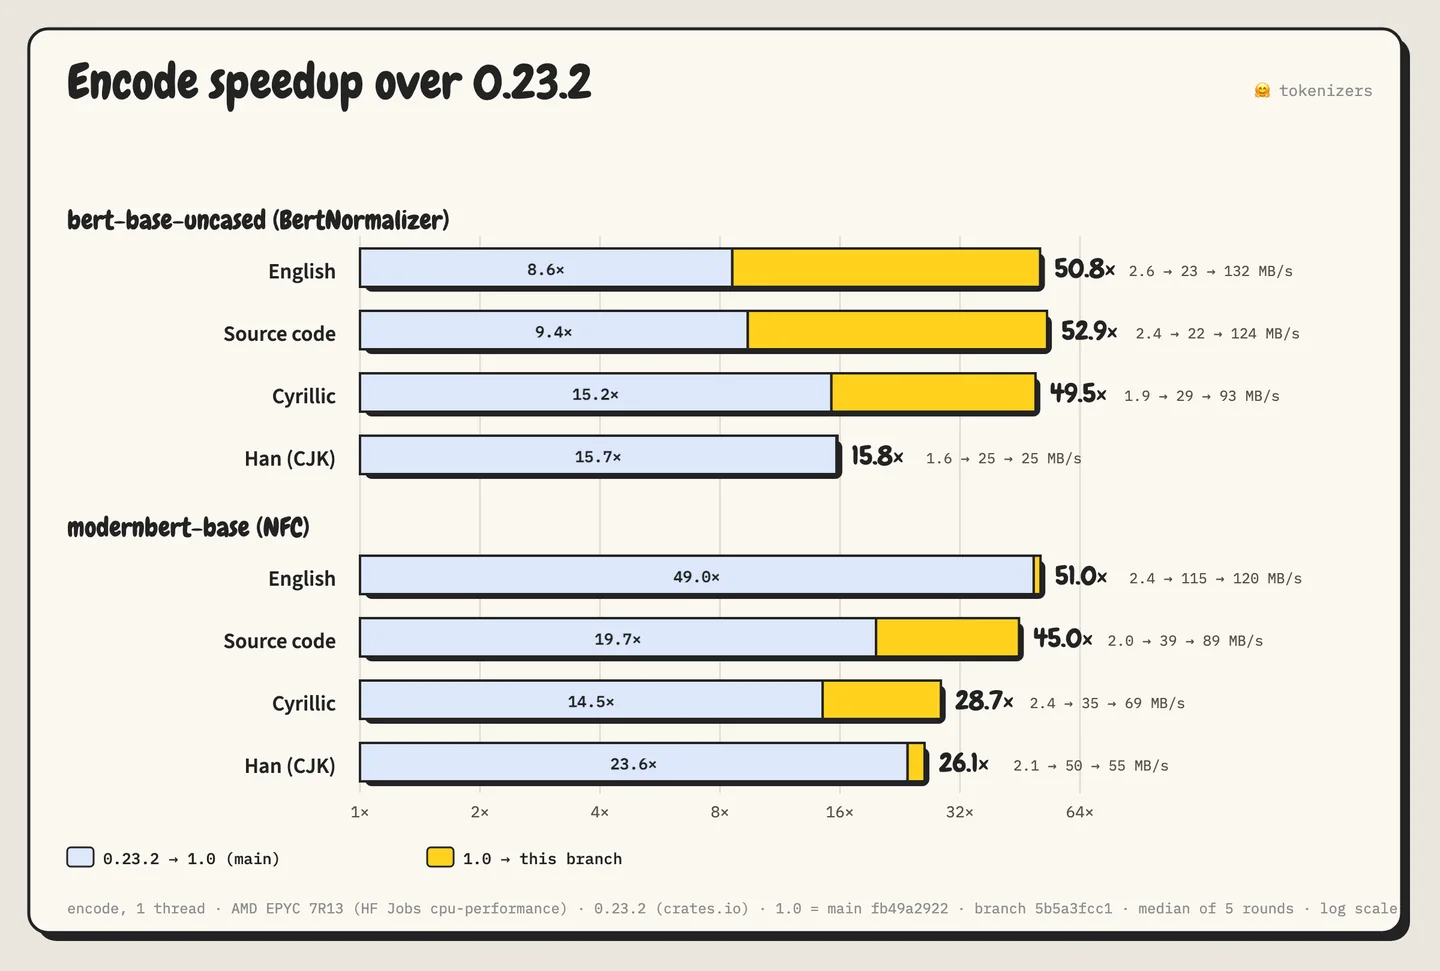
- Le benchmark annoncé compare le débit d’encodage à tokenizers 0.23 ; le gain BERT total annoncé atteint environ 50× sur le protocole des auteurs.
- Les auteurs isolent notamment le coût de normalisation et les chemins ASCII. BERT/WordPiece reste utilisé pour embeddings, reranking et classification.
- Au moment du billet du 15 octobre, ces changements sont encore dans une pull request ; une version 1.0.0 est en préparation.
Ce qui change
Profilage et choix du corpus déterminent la portée de l’optimisation.
Implication pratique
Tester les langues et caractères de son corpus et attendre ou épingler explicitement la version adoptée.
Disponibilité
Code et reproducer publics ; ne pas présenter les optimisations comme déjà incluses dans une version stable publiée.
Limites et incertitudes
Un facteur sur la tokenisation n’est pas un facteur équivalent sur l’inférence ou la latence de bout en bout ; résultats rapportés, non reproduits ici.